


大多数公司以为,给 AI 的资料越多、接的工具越多,它就越能干。但我们落地项目后发现,真正决定成本和准确率的,是它每一轮背了多少用不上的东西。
这篇算一笔容易被忽略的账:上下文。它不是模型参数,是 AI 每次对话背着的行李。给要签字的人和要算账的人。六分钟。
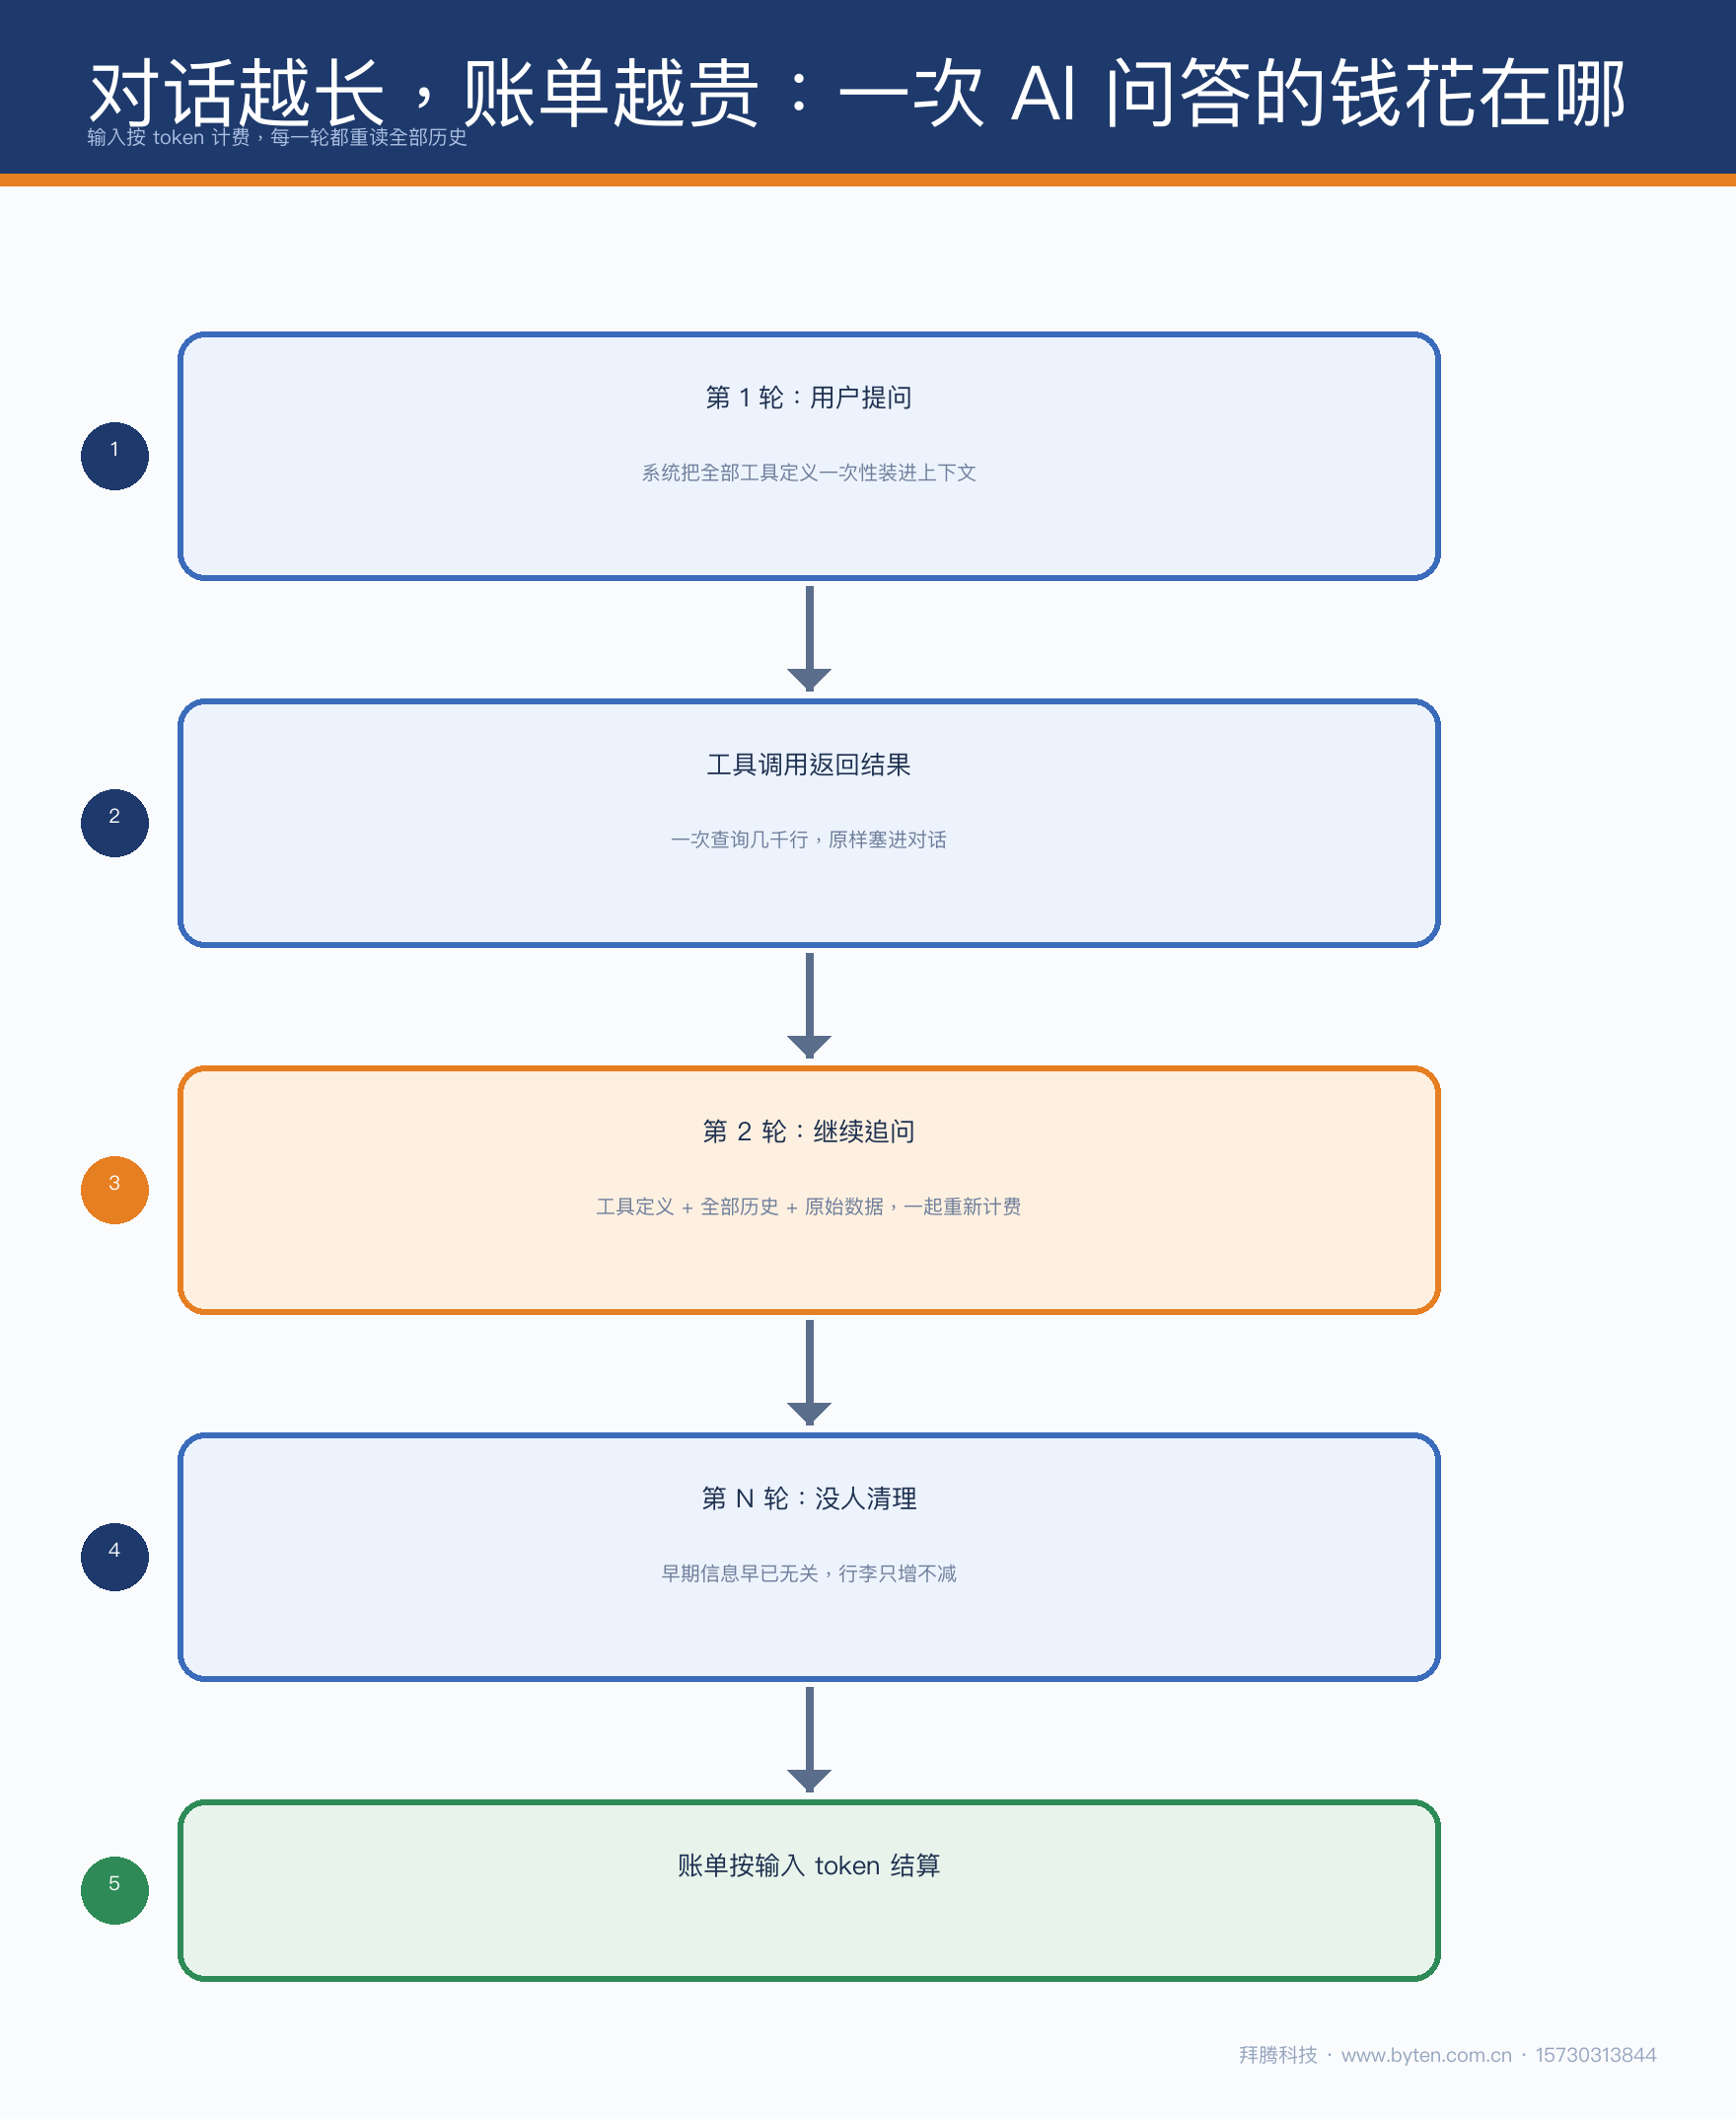
模型本身没有记忆。每回答一句,它都要把之前的工具说明、查询结果、聊天记录,全部重读一遍。
计费按 token 算,输入也收钱。对话越长,每一轮要重读的内容越多,账单像滚雪球。
麻烦的是,这部分钱不产生任何新答案。它只是用来"重读旧行李"。而且行李越重,模型越容易分心:无关信息塞满窗口,该注意的那句反而被淹没。贵,还连带慢和错。
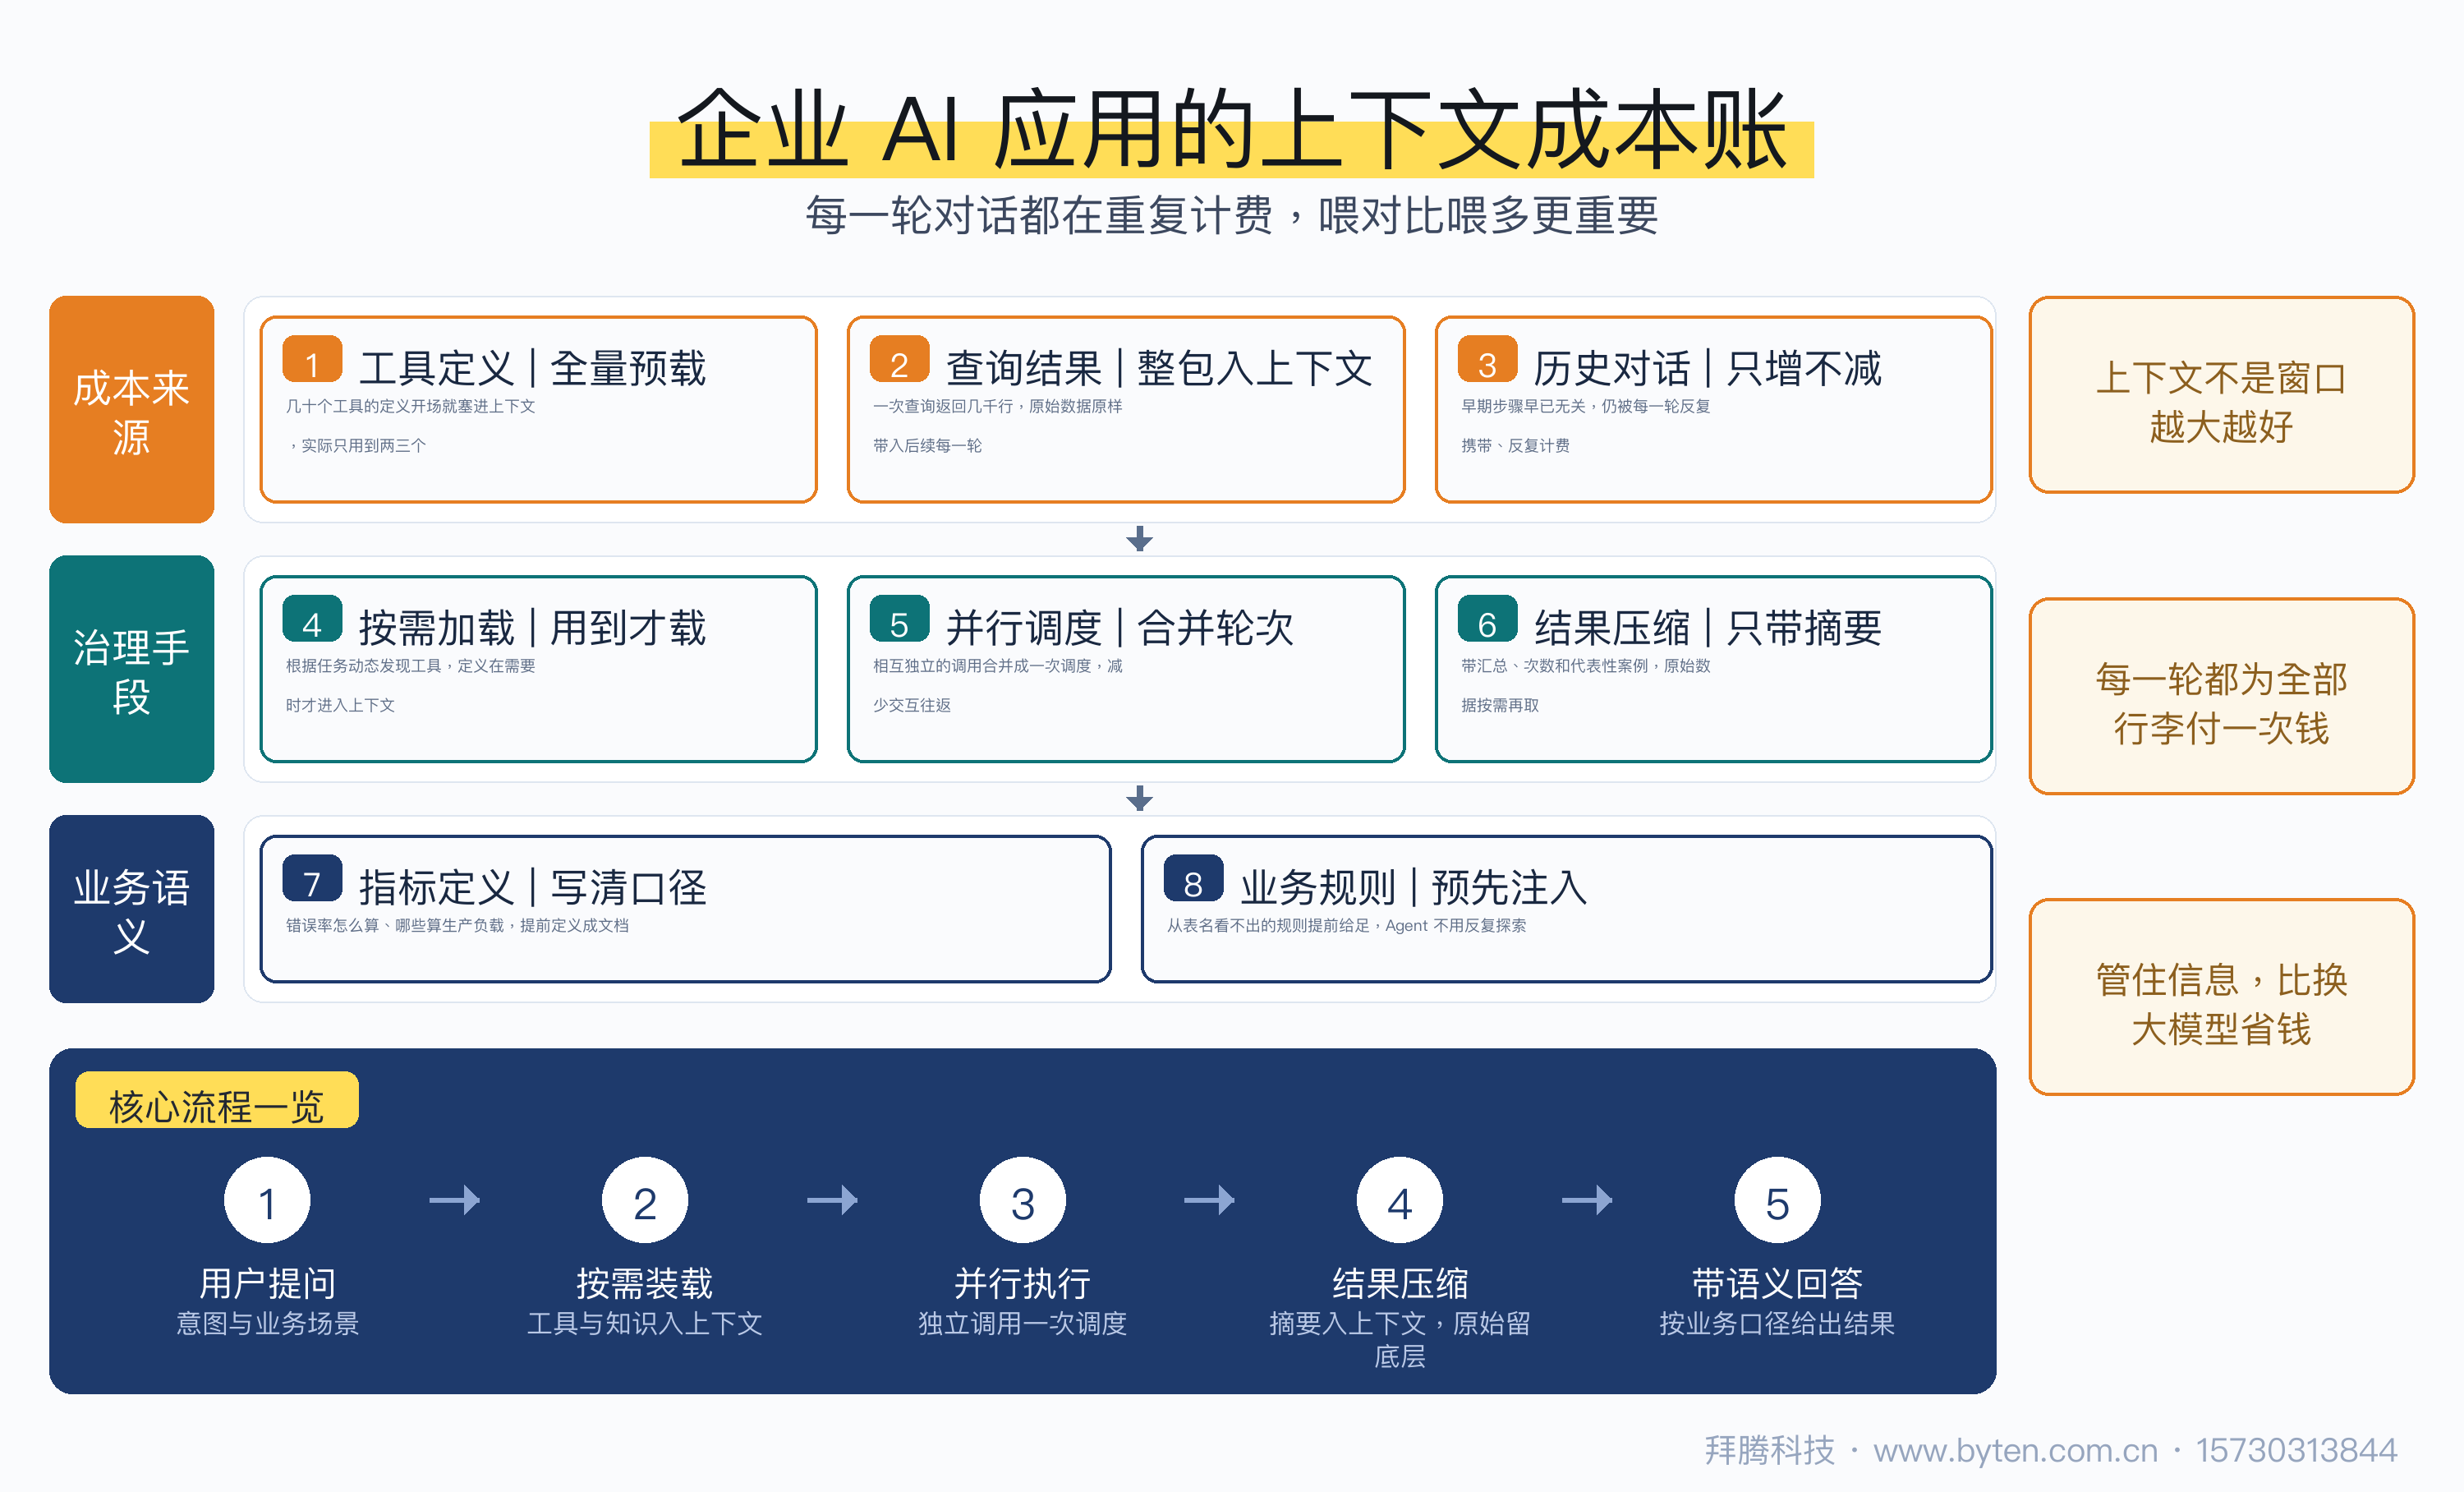
工具定义全量预载。系统一启动,就把几十个工具的说明书塞进上下文。这次任务实际只用两三个,剩下的全部陪着计费。
查询结果整包入上下文。一次查询返回几千行,原样放进对话。后面每一轮,都在为这几千行付一遍钱。
历史对话不清理。早期调查的中间过程,到了第十轮早就无关了,仍然全程携带。
11 月 12 日,InfoQ 报道了 Snowflake 的做法。他们的 AI 助手做了三件事:工具按需加载,用到才载入;相互独立的调用合并成一轮,减少往返;大结果压成摘要,原始数据按需再取。
效果有一组基准数据。在内部 SQL 修复测试里,这套做法三次试验通过率 86%;作为对照的通用编码工具是 72%。单次成本从 0.446 美元降到 0.298 美元,降了 33%。
边界要说清:这是特定配置和工作负载的结果,不等于你的项目也能降三成。但方向可信——先把上下文管住,再谈换模型。
上下文管好了,只是效率上去了,不代表答案就对。
Snowflake 举过一个例子:Agent 去查一次故障的错误率,SQL 写得对,数字也算出来了。但它不知道哪些负载是生产环境、哪些测试任务该排除、公司对"错误率"的定义是什么。
这些规则从表名和列名里看不出来。缺了它们,AI 会给你一个看起来合理的错数。
解法很朴素:把业务规则写成文档,把指标口径提前定好,喂给 AI。让它少猜,而不是每次自己探索。
不用懂技术,用加减乘除就能估出量级。假设一个内部助手,一次会话问答十轮。
不做治理:工具定义加上全部历史,再背几千行查询结果,单轮输入算两万 token。十轮下来,二十万 token 的输入。其中大部分是重复内容,付了十遍钱。
做了治理:工具按需加载,结果压成摘要,历史定期清理,单轮输入压到三千 token。十轮三万,输入差出六七倍。
数字是示意,用来算量级,不是实测。方法本身可以直接搬走:让供应商把"单轮平均输入 token"和"会话轮数"这两个数报出来,成本量级当场就清楚。
把上下文治理写进验收,不需要懂技术,问四句就够:
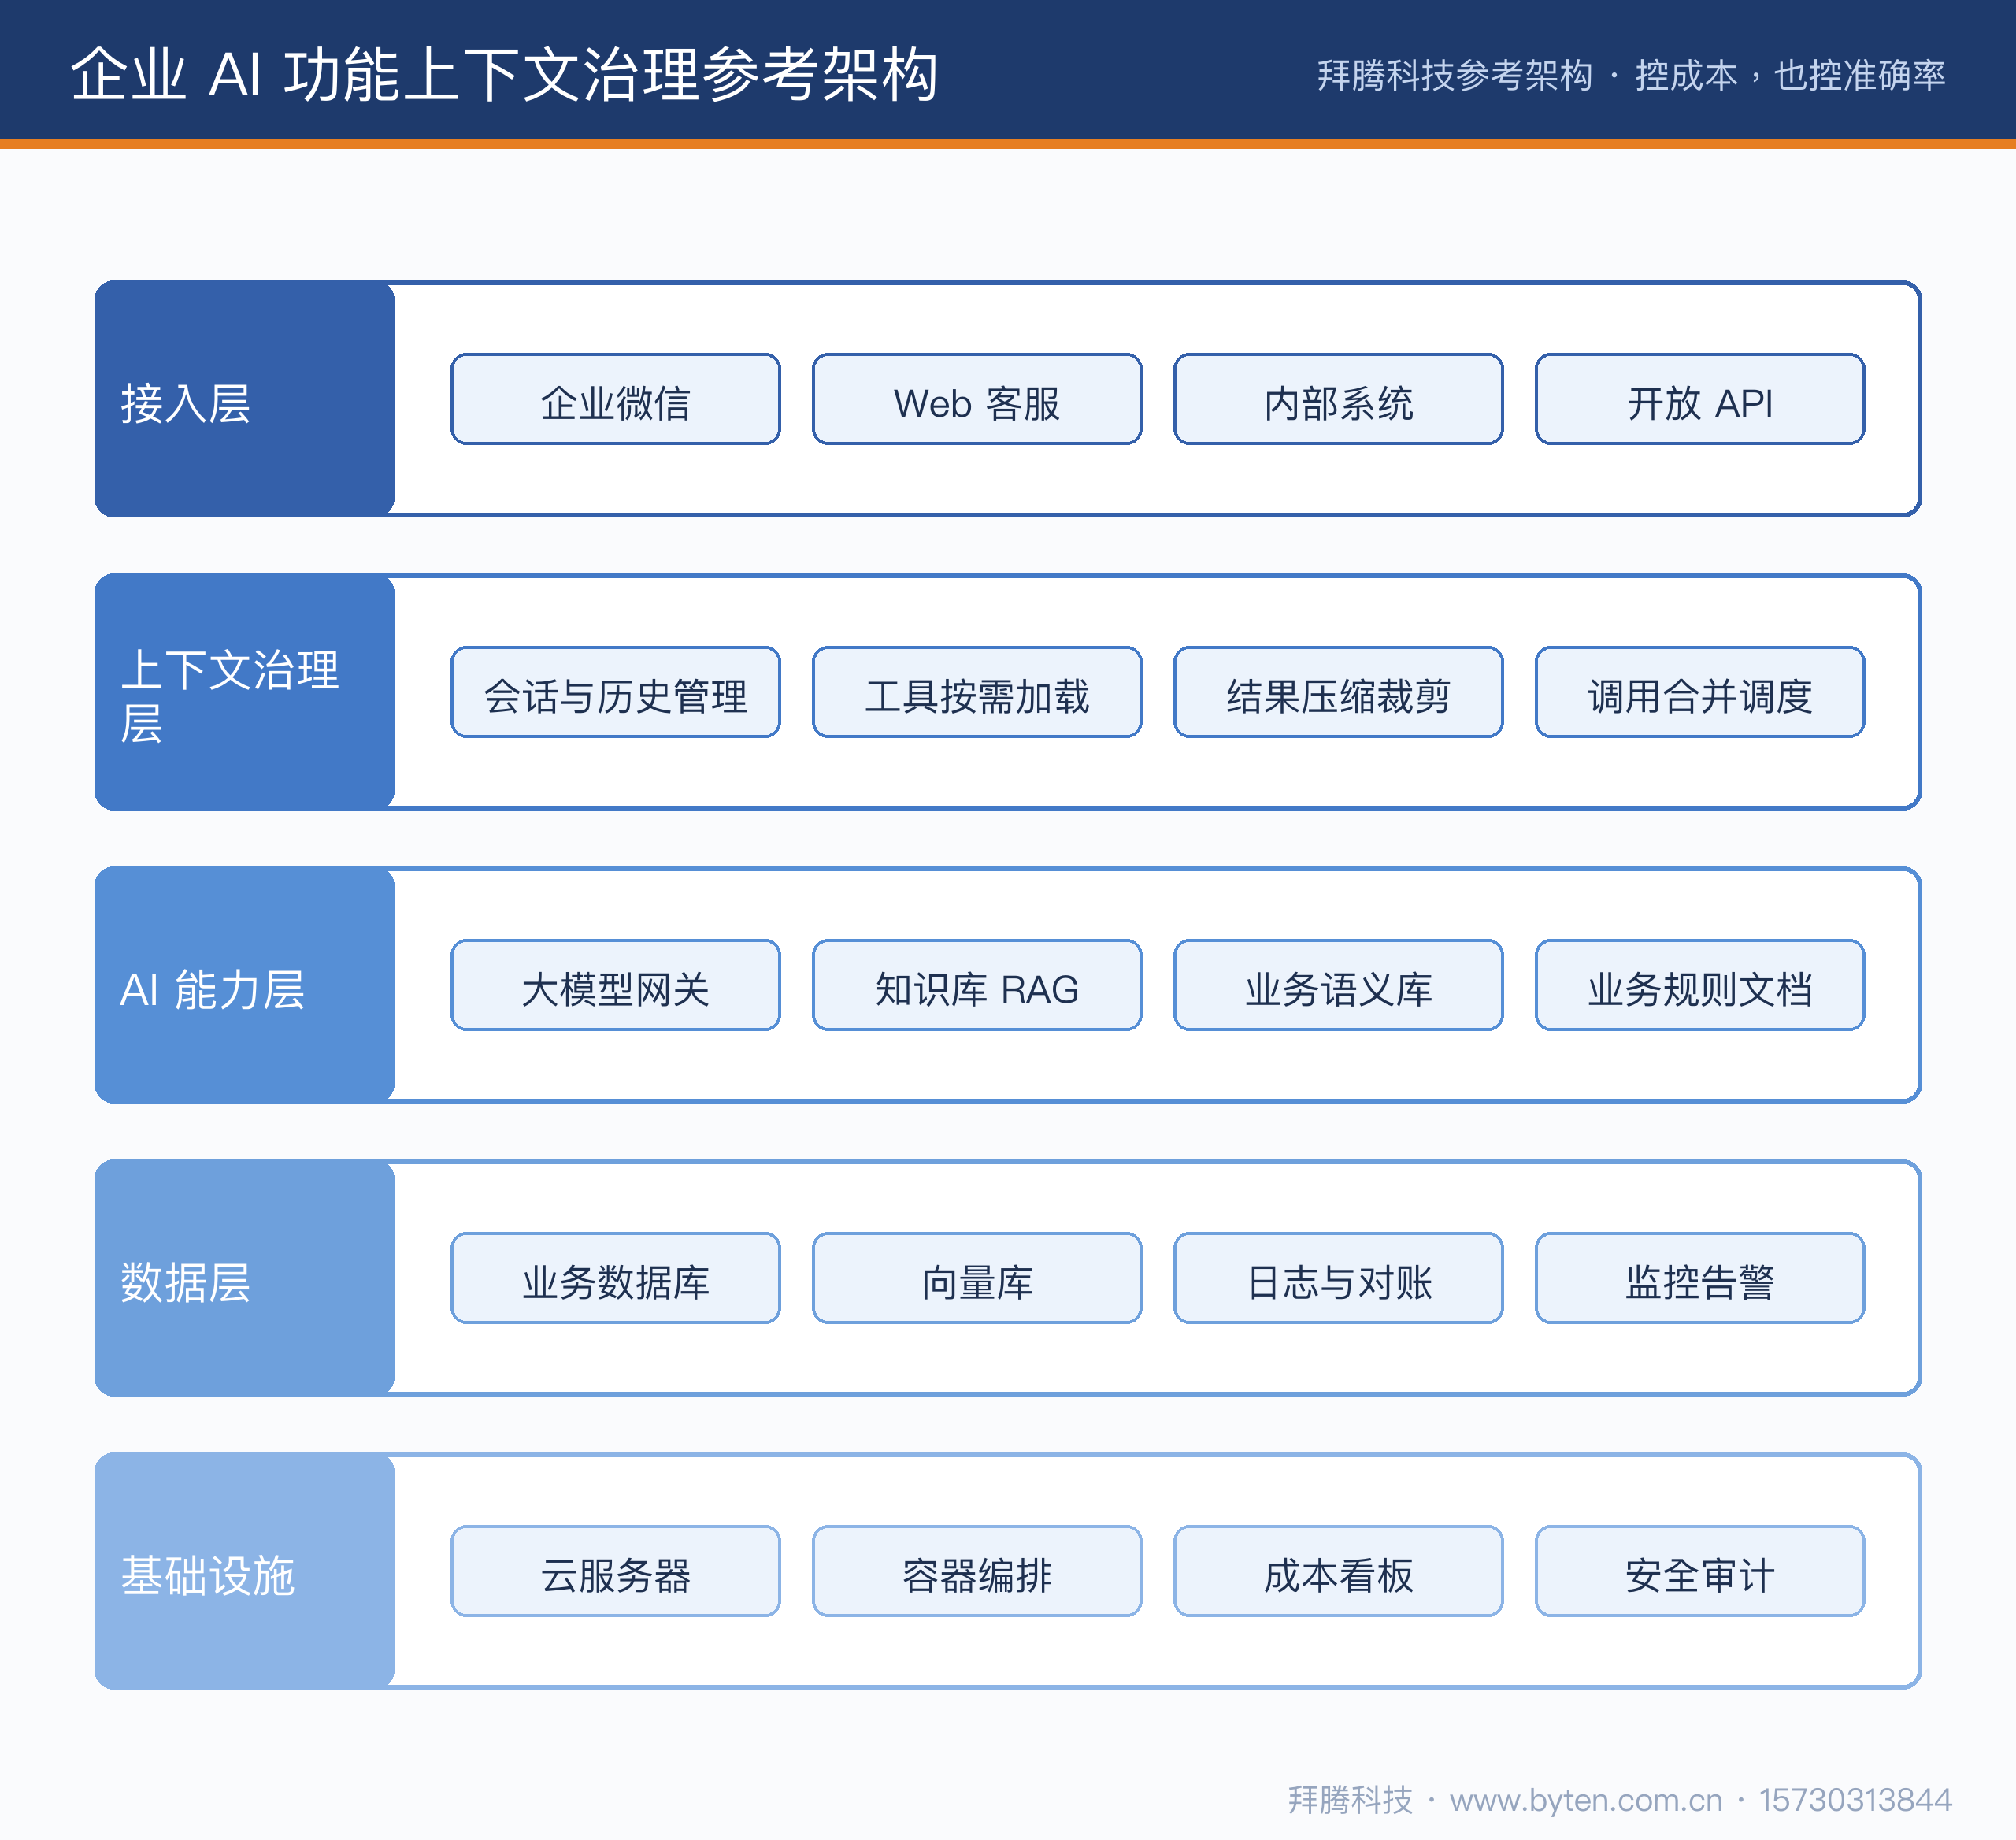
一、单次会话的 token 账怎么算,有没有成本看板。
二、工具是不是按需加载,查询结果有没有做压缩和裁剪。
三、会话历史怎么管理,多长的对话会触发摘要或清理。
四、业务规则放在哪——是每次临时拼进提示词,还是一份可维护的文档。
再加一条动作:上线后每月对一次账,看单次会话的平均成本是涨是跌。涨了先查上下文,再怀疑模型。
下次评估 AI 功能,别只问"接的哪个模型"。先问它每轮背多少东西、业务规则谁来定。这两件事定成本,也定准确率。
模型降价是别人的红利,上下文管住才是自己的。
如果你正在评估类似方案,把你的场景留言或私信给我们,免费出一份「流程图+架构图+报价明细」方案。
15730313844(同微信)|官网 www.byten.com.cn
—— 拜腾科技,帮企业把 AI 接进业务系统
什么是 AI 的上下文?为什么影响成本和准确率?
上下文是模型每轮回答时携带的全部信息:工具定义、查询结果、历史对话。计费按 token 算,输入也算钱,携带越多越贵;无关信息越多,注意力越分散,回答越容易出错。管住它,成本和准确率一起改善。
企业 AI 功能一年的调用成本大概多少?
取决于对话轮数和单次会话的 token 量。做了上下文治理的客服类应用,单次会话通常在几分到几毛钱;不做治理可能贵 3 到 10 倍。签约前应要求供应商给出估算模型和成本看板。
怎么判断供应商做的 AI 功能会不会越用越贵?
看三点:工具是否按需加载、大结果是否压缩裁剪、历史会话有没有清理策略。再要一份月度成本报表样例。四条都答不上来的,成本风险在自己身上。
成都做企业 AI 应用定制开发多少钱?
单场景 AI 功能 8 万到 25 万,Agent 项目 10 万到 30 万,周期 6 到 12 周。应包含上下文治理和成本看板。成都本地可上门,全国远程交付。

