


11 月 16 日上午,一个做售后工单系统的客户把账单截图发到群里:9,600 元。三个月前,这个数是 2,900。
他第一句话是「是不是你们调用量算错了」。第二句是「模型是不是涨价了」。
都不是。模型没换,9 月 10 日之后那档价格还降了,缓存命中从 0.05 元降到 0.02 元每百万 token。钱花在了别的地方——上下文。这篇把这笔账拆开,给要签字和要算账的人。八分钟。
把他家三个月的数据摊开:日均提问量从 1,900 涨到 4,000,涨 2.1 倍;单次调用平均输入从 4,200 token 涨到 12,400,涨 3 倍;缓存命中率从 61% 掉到 3%;月账单涨 3.3 倍。
提问量的涨幅对不上账单的涨幅,缺口全在中间两行。这两行平时没人看,因为它们不在「提问量」这个口径里。
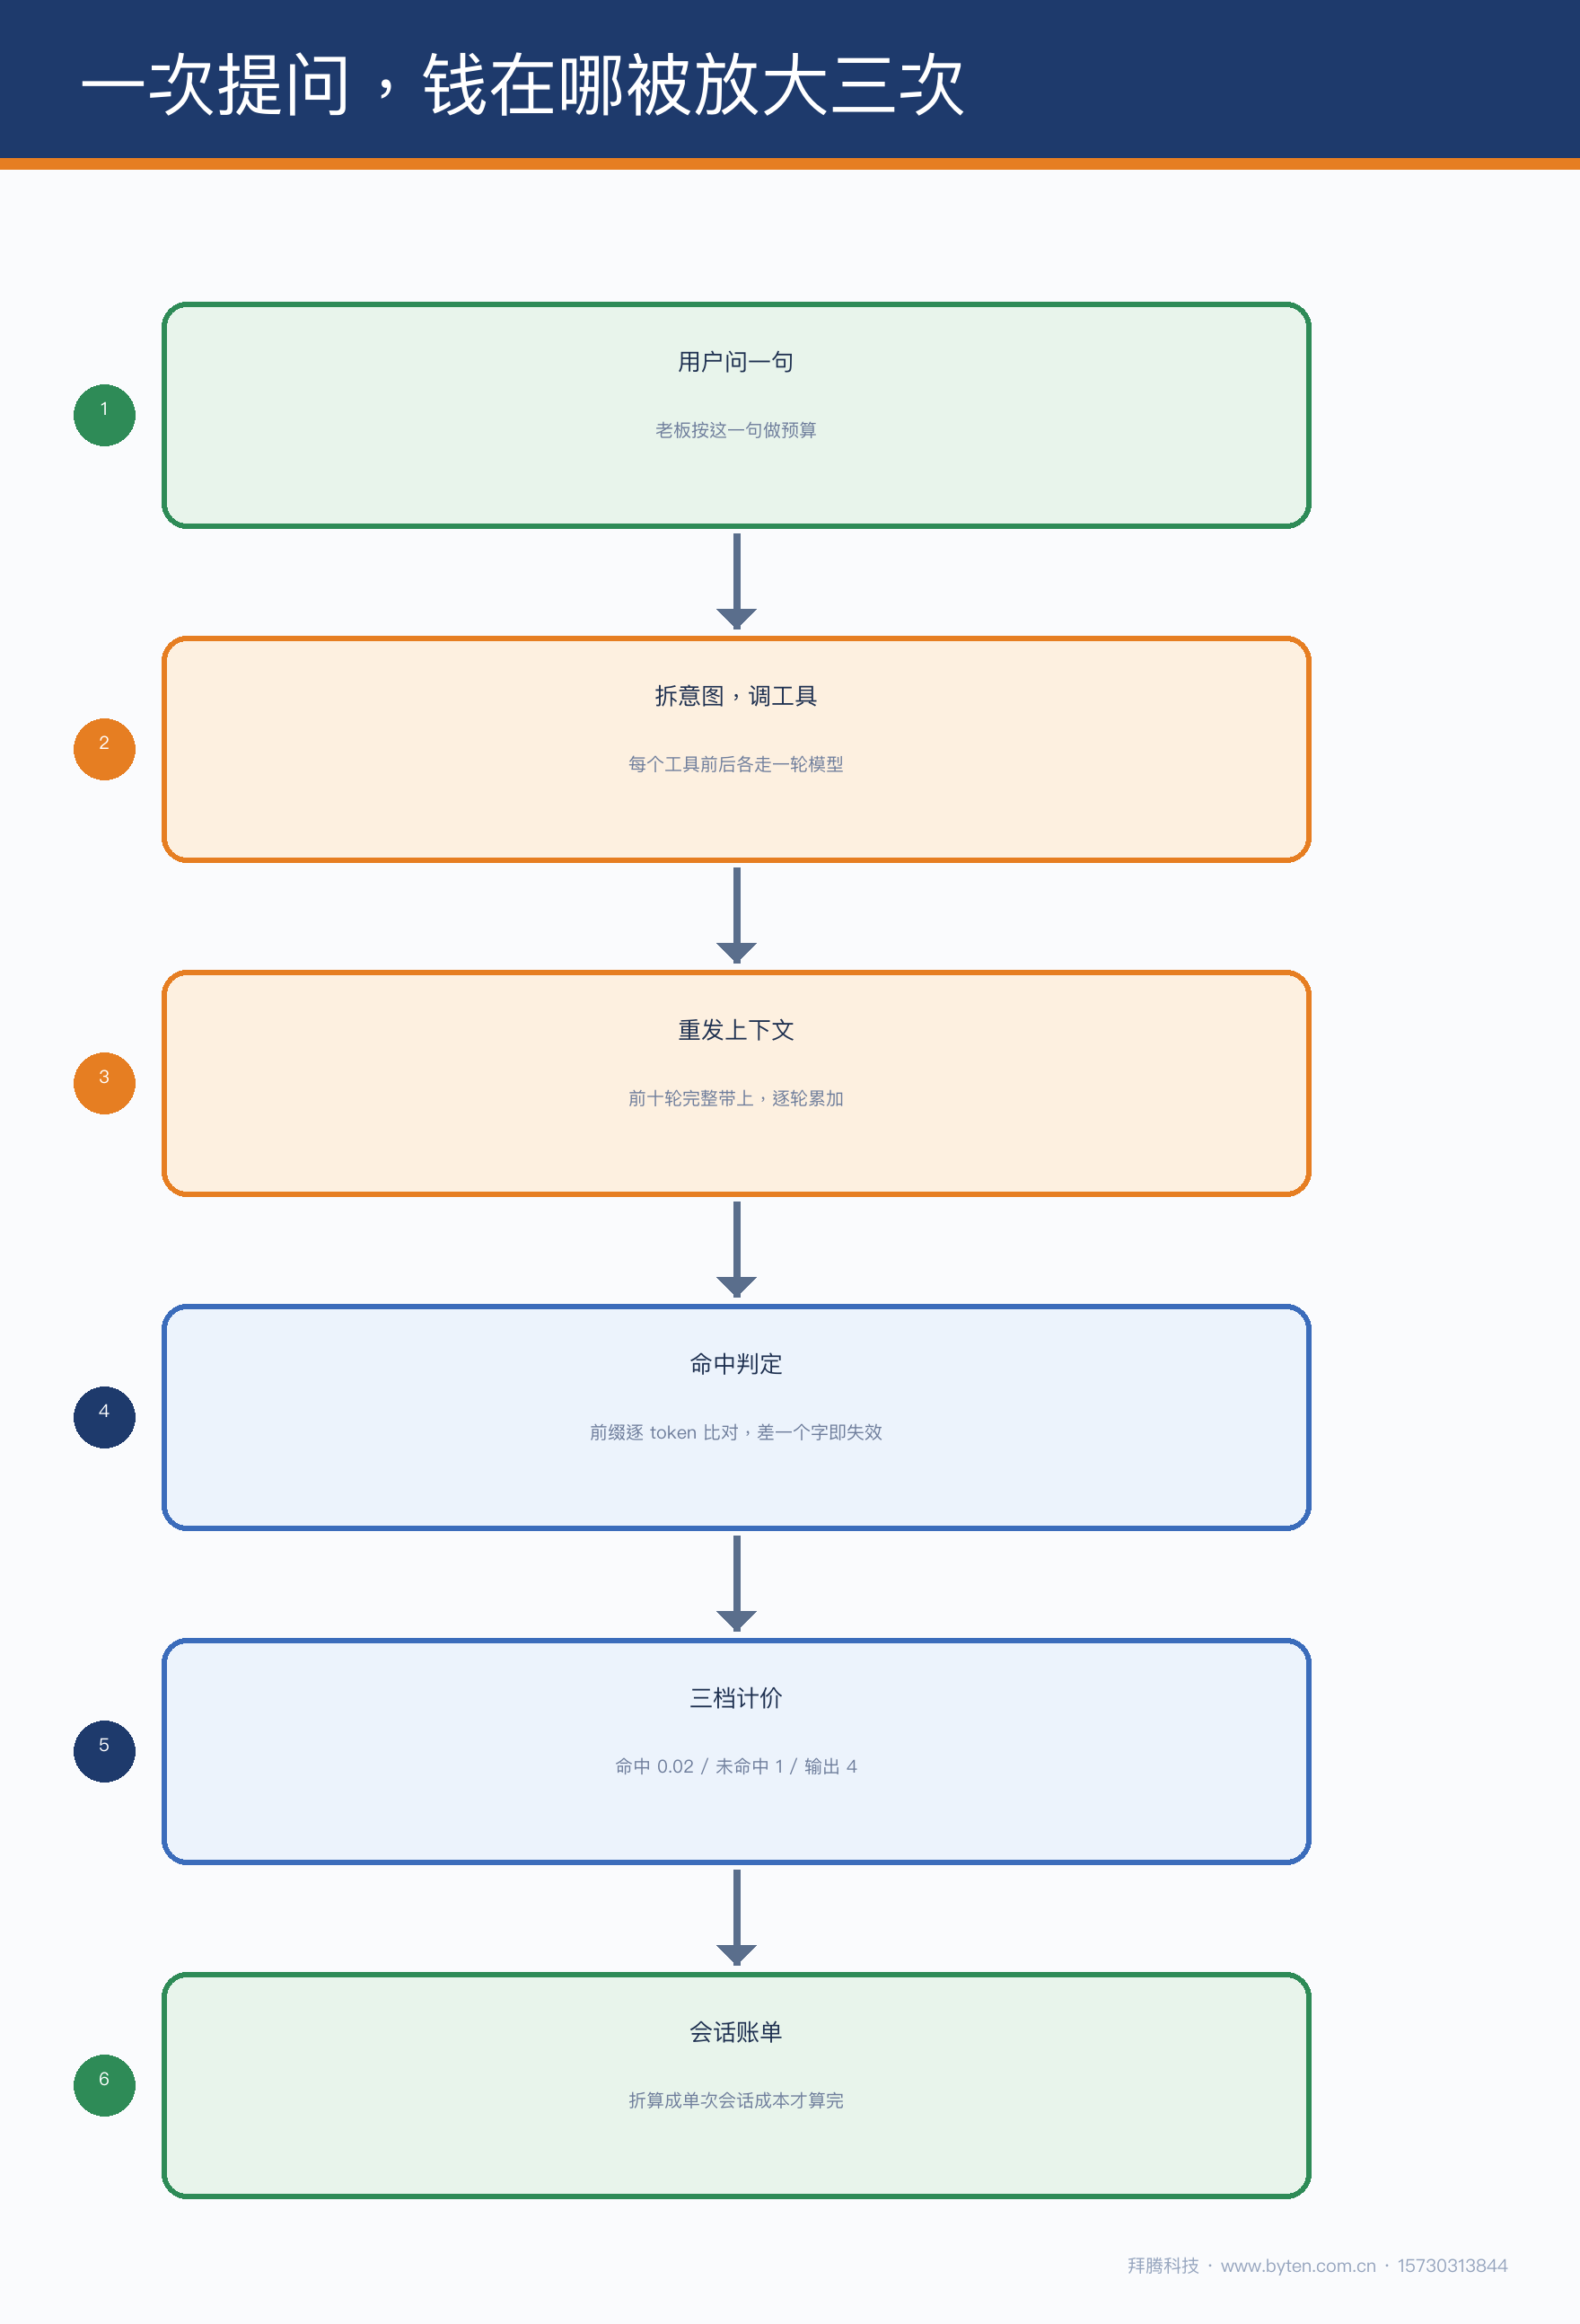
老板做预算按「用户问了多少句」,账单按「模型被调了多少次」扣。一个挂了工具的 Agent,每用一次工具,前后至少各走一轮模型:决定调什么,一轮;拿到结果决定下一步,一轮。
公开能查到的参照:神州控股科捷的供应链智能体「捷小果」,双 11 期间 13 个业务部门、1.4 万轮对话、9.5 万次工具调用。9.5 万除以 1.4 万,平均每问一句 6.8 次工具调用。
按「工具调用前后各一轮」推,一句提问对应 7 到 14 次模型调用。这是我的推算,不是他们的口径,但量级不会差太远——只要你的 Agent 挂了三个以上工具。
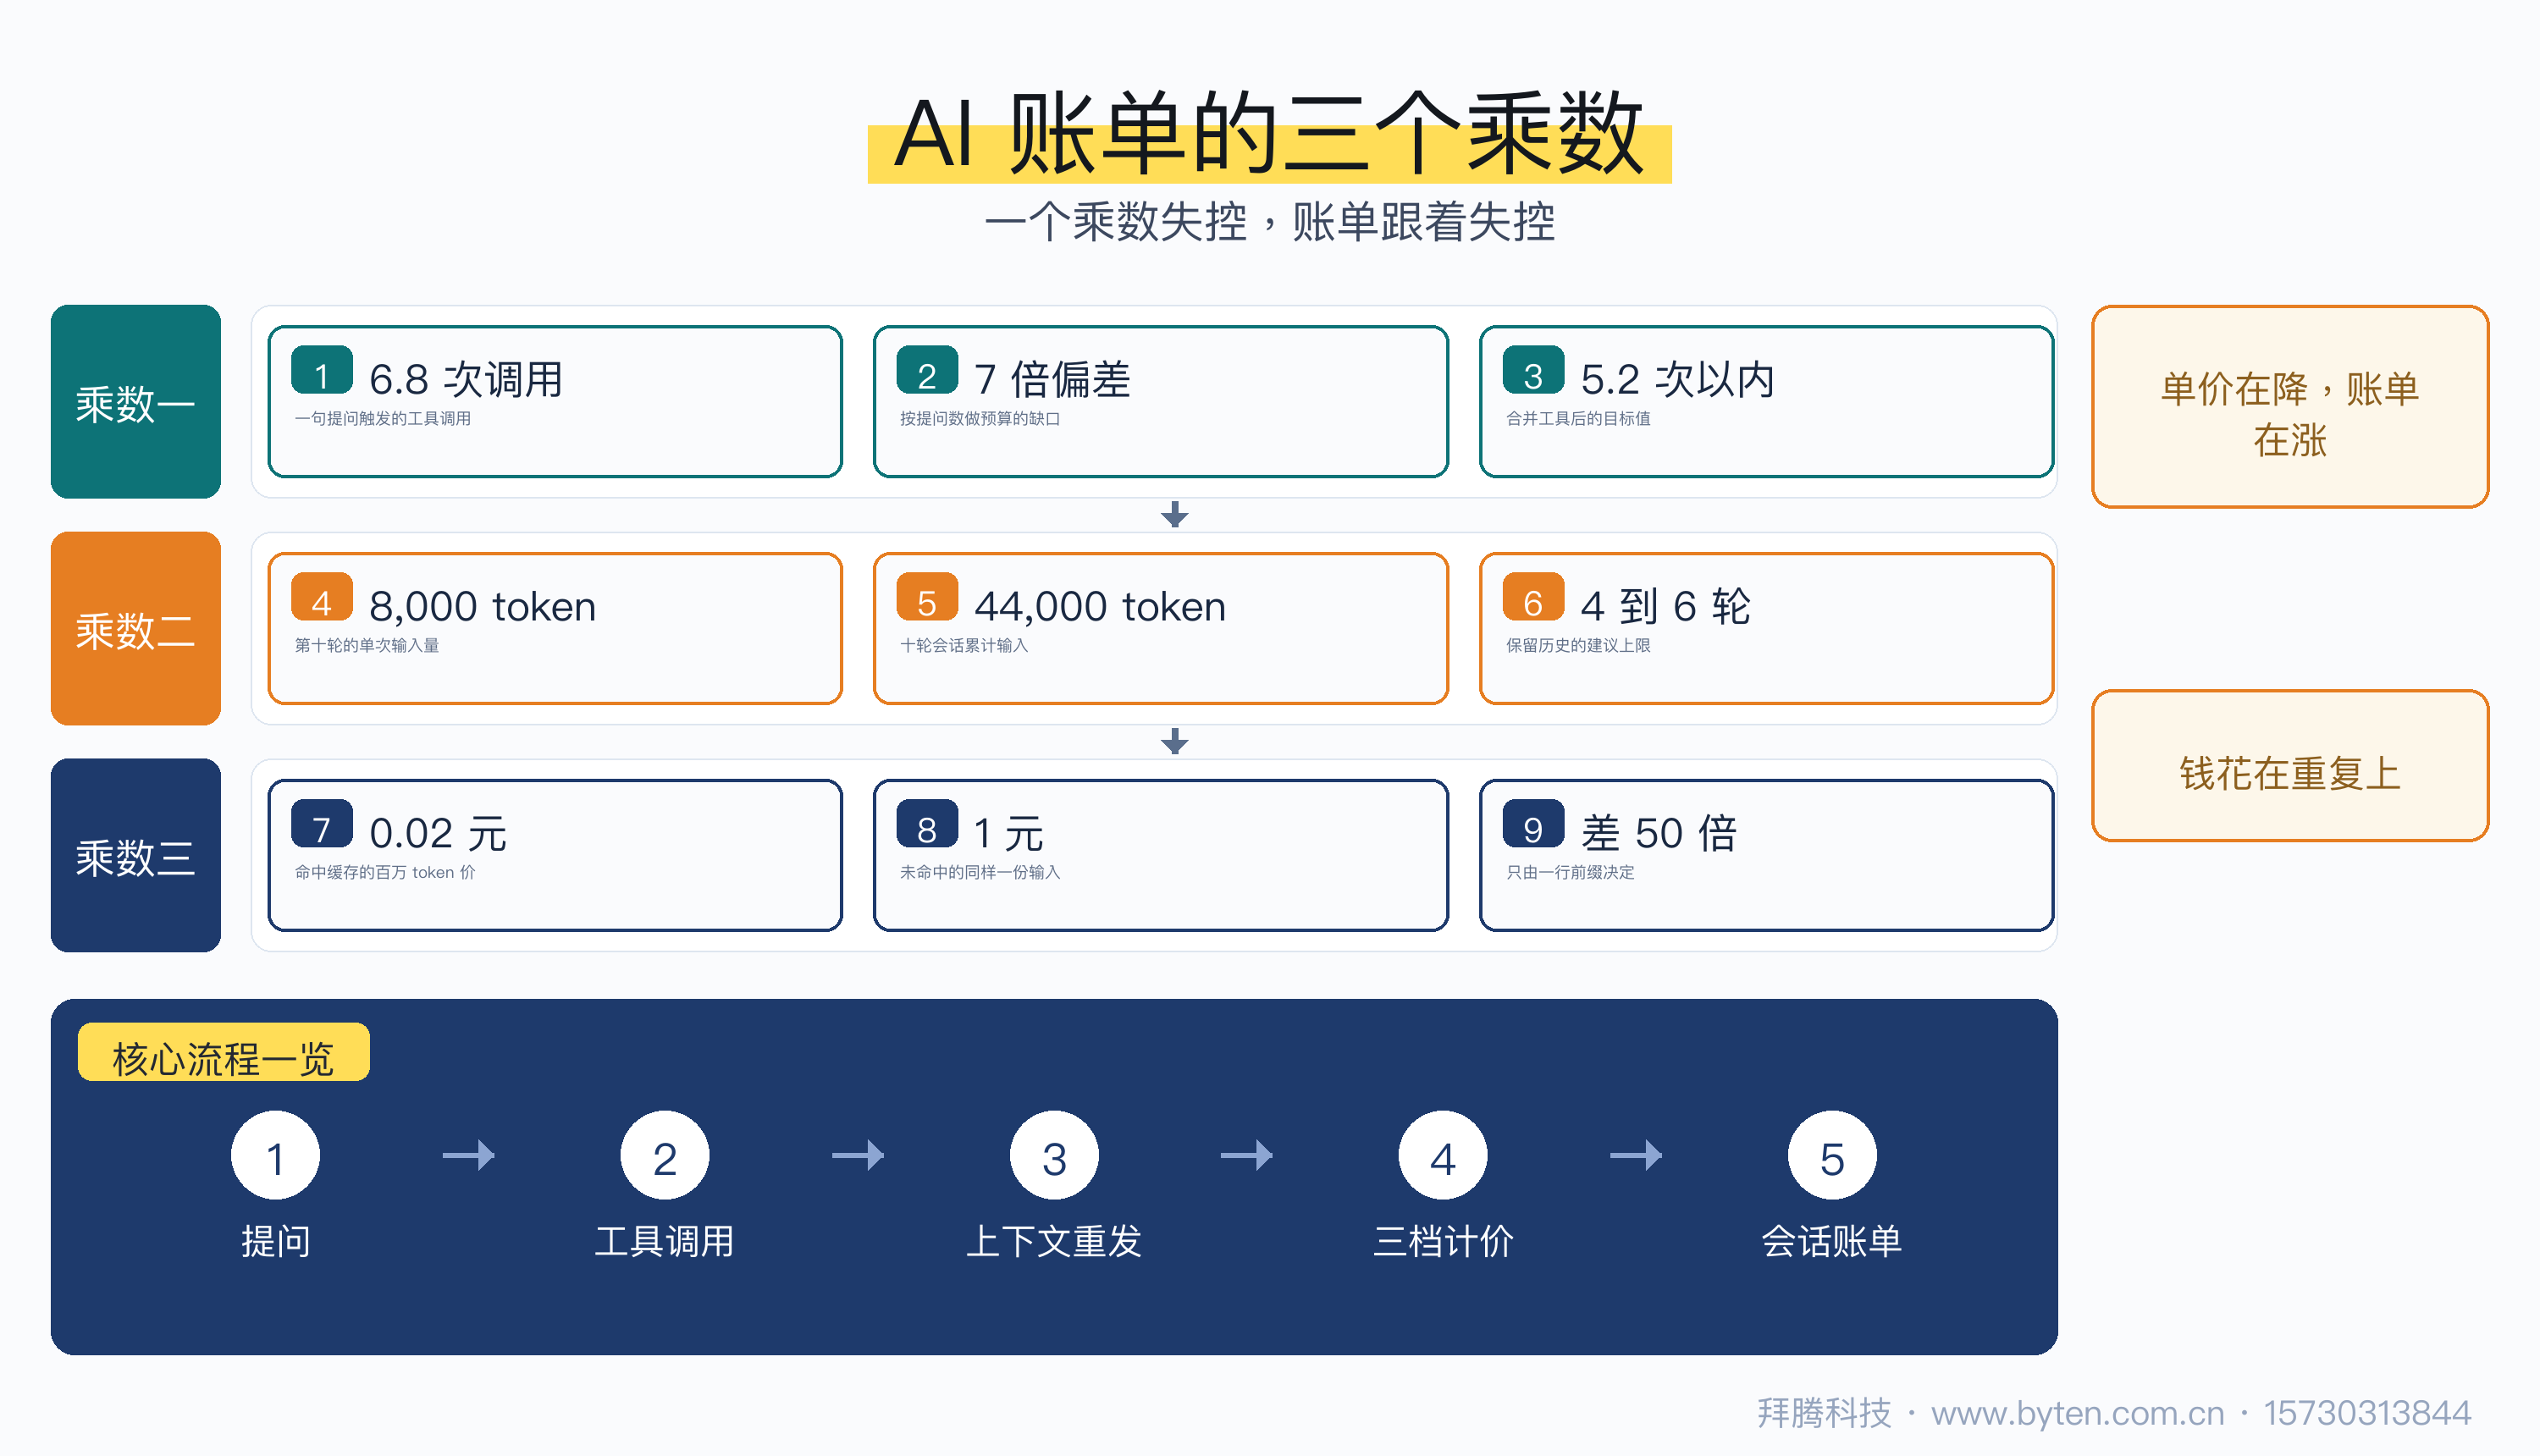
模型没有记忆。第十轮请求,要把前九轮完整重发一遍。十轮会话、每轮新增 800 token,第十轮单次输入 8,000 token,整个会话累计 44,000。
用户什么都没多做,只是多聊了几句。这就是为什么客服类应用最容易失控:不是用户多,是每个人聊得久。
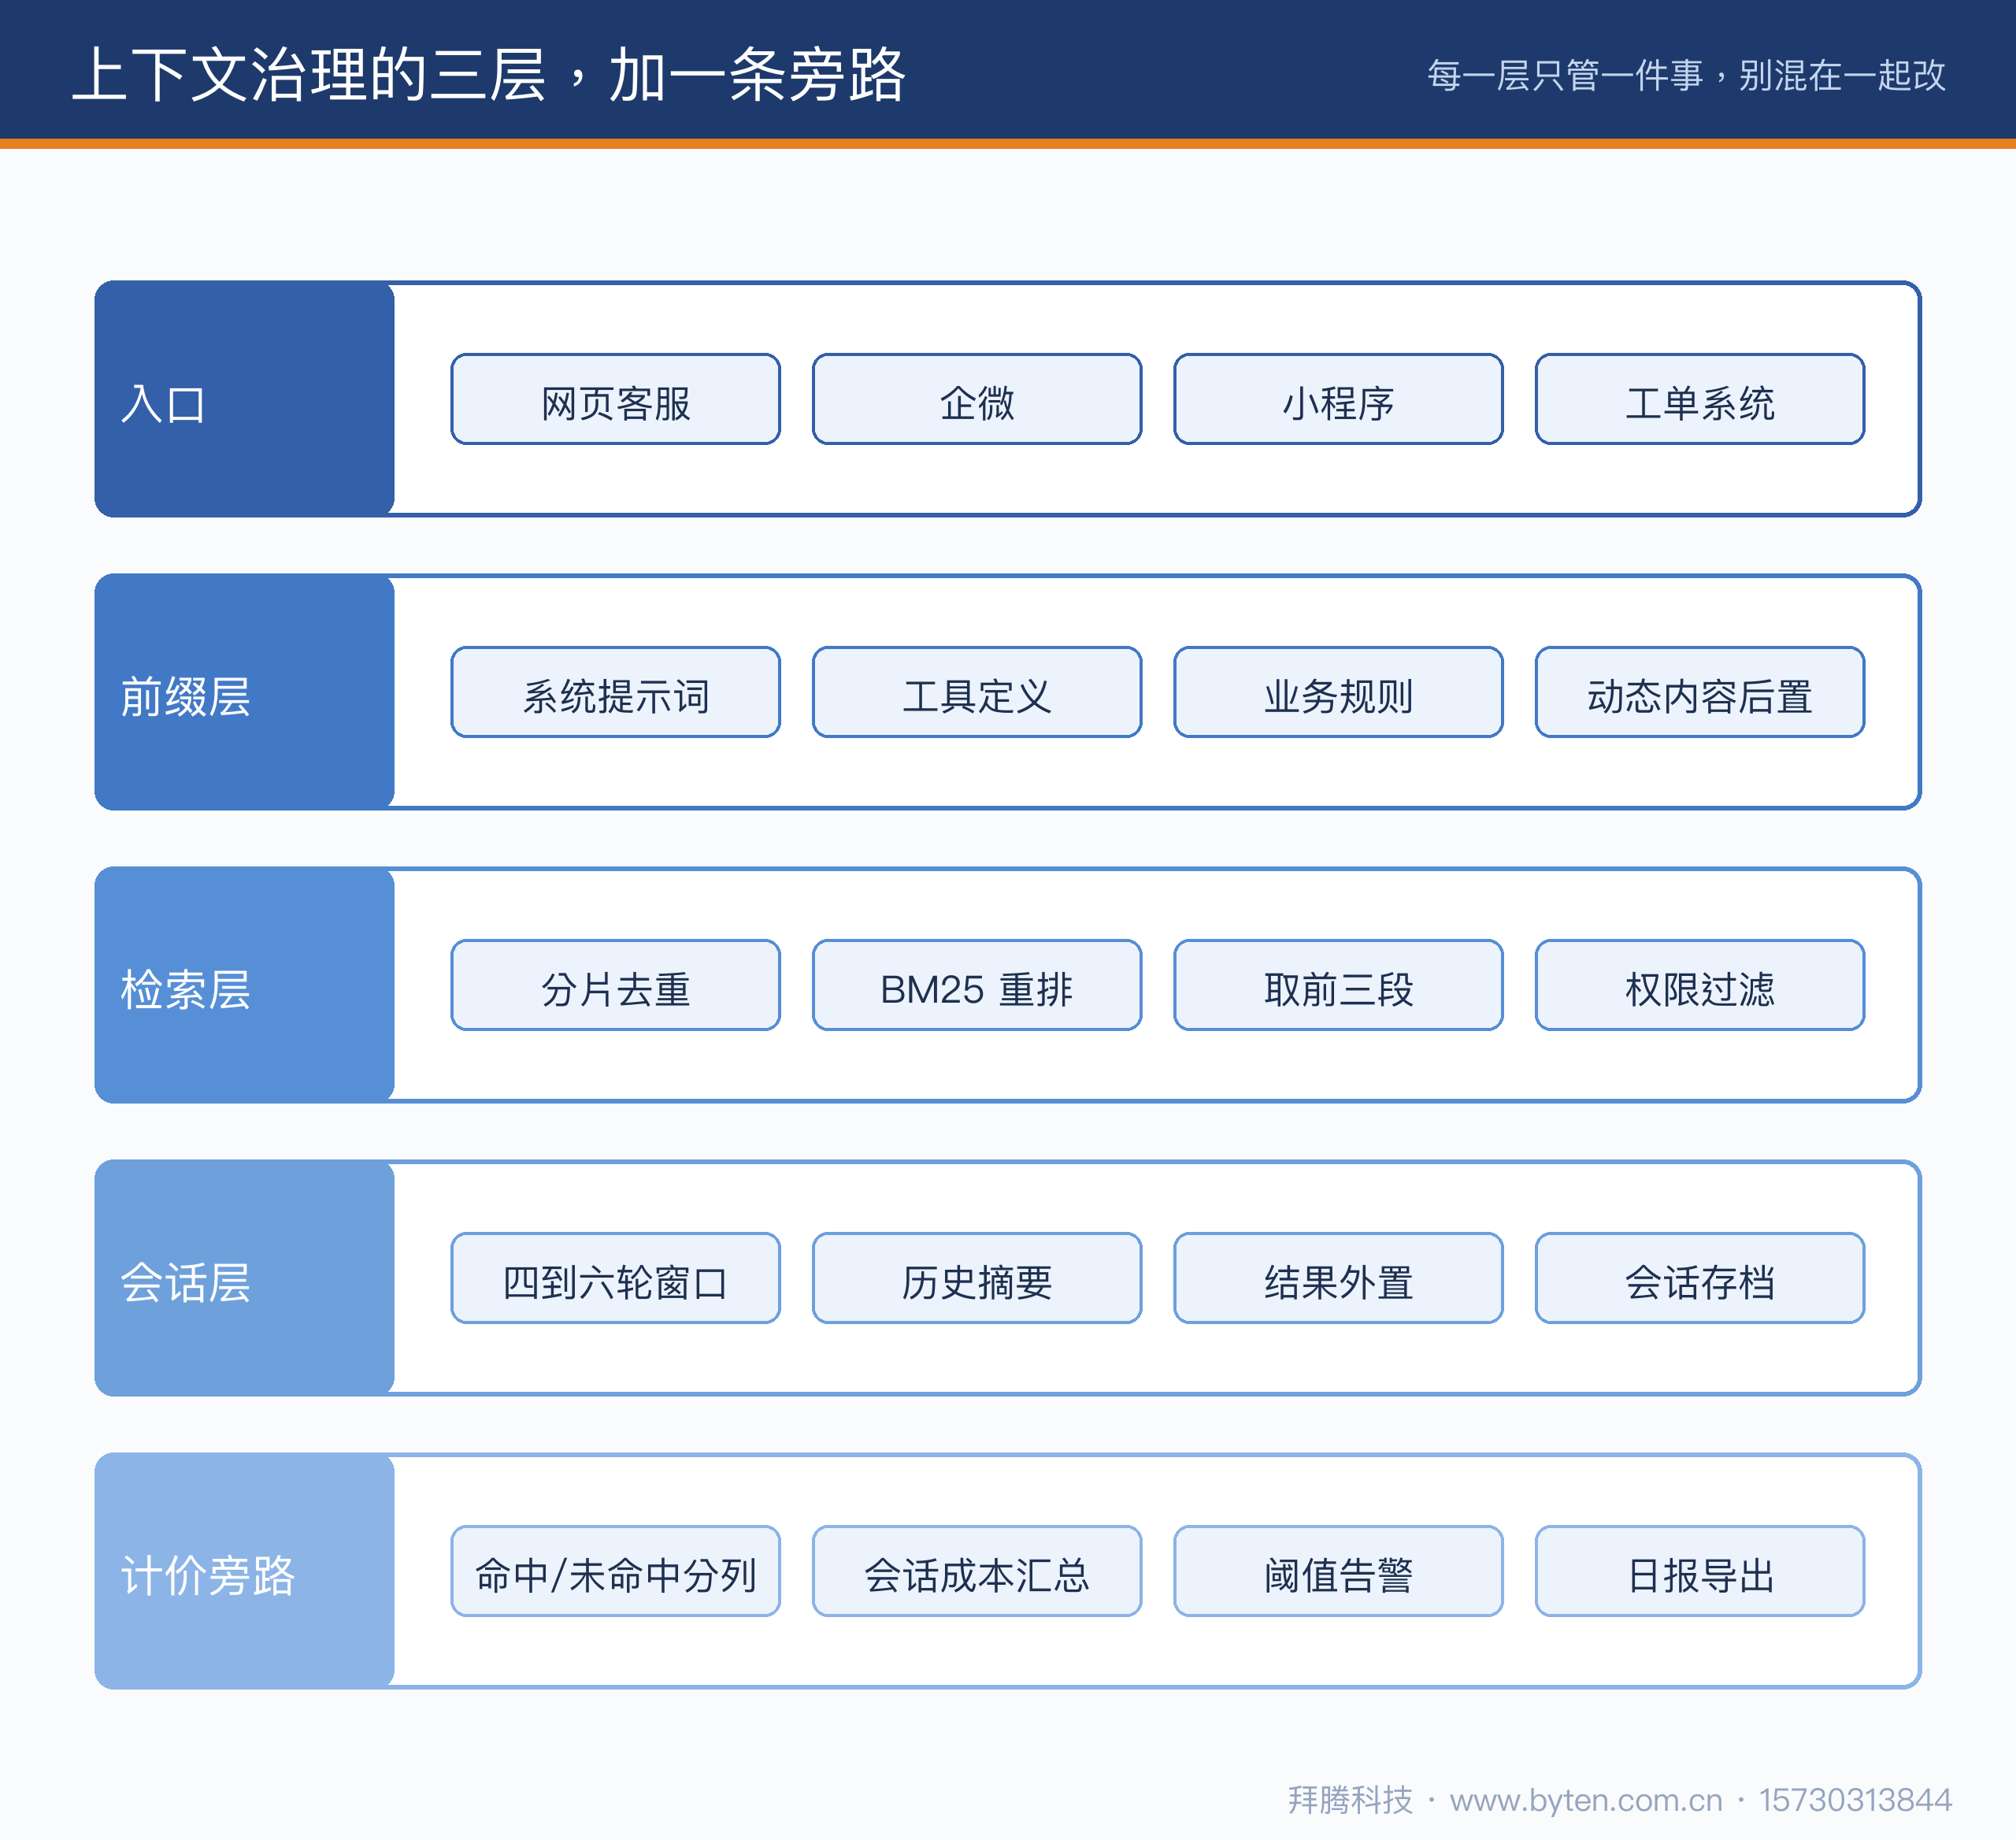
工程上的减法只有三种:截断最便宜也最伤;摘要把老轮次压成一段两百字的结论;外置是把结果落库,上下文里只留一句引用,需要时按编号取回。
这是最陡的一档,也最少人提。公开价目表上(2026 年 9 月 10 日起生效的 deepseek-v4-flash 系列,空闲时段):缓存命中的输入 0.02 元每百万 token,未命中 1 元,输出 4 元,高峰时段翻倍。
命中与未命中,差 50 倍。命中的条件是前缀逐 token 完全一致——注意是逐字,不是意思相近。
所以决定这 50 倍的,经常是一行代码的位置。这家客户的 system prompt 第一行写着「当前时间:2026-11-16 09:14」。每轮前缀都不同,缓存全部作废,输入单价从 0.02 元跳回 1 元。8 月命中率 61%,10 月 3%。
修正办法很便宜:稳定内容放前面,动态内容挪到末尾。几十行代码的改动。
口径先写清:日均 4,000 条提问,每问 6.8 次调用,单次输入 12,000 token、输出 300 token,每月 22 个工作日,按空闲时段单价。
不做治理:月输入 7,180 百万 token,约 7,180 元;输出约 717 元;月账单 7,900 元左右。
做了治理:合并工具(每问 5.2 次)、单次输入压到 3,800、命中率回到 62%,月账单约 1,260 元。
一个月差 6,600 元,一年接近 8 万。必须说清:这些数按公开价目表推算,不是任何一家的实测账单,偏差两三成很正常,但量级可以直接拿去对。
另一个项目反向翻车。客户嫌账单高,让团队把检索回来的文档片段从 3,000 token 砍到 500,历史一轮没动。
结果账单只降 9%,答错率上去了,一周多三条客诉,一线同事开始不用它,绕回人工。
省钱的顺序是有讲究的:先砍重复的,再砍过期的,最后才砍信息本身。反过来做,省下的是钱,赔进去的是可信度。
三条,对上就别管:
月账单不到 500 元——治理要 1.5 到 3 人月,省的钱回不了本。单轮输入本来就在 3,000 token 以内、也不调工具——没有乘数,就没有放大器。一次性批处理——跑完就结束,历史不累积。
反过来,只要「有工具调用」和「有长会话」同时成立,这笔账一定失控,只是早晚。
一、能导出按会话汇总的 usage 报表吗?要分三列:缓存命中输入、未命中输入、输出。只有一个总数的报表,等于没有报表。
二、单轮输入 token 的中位数是多少?缓存命中率连续七天是多少?我们的线是 8,000 以内、60% 以上,越线就返工——是我方经验值,不是行业标准。
三、每问触发多少次模型调用?分母是提问数还是会话数?这个问题答含糊,预算就一定会被放大五到十倍。
11 月 15 日,DeepSeek 的 App 和网页版开始限制超过 7 天不活跃的长对话,单次输入缩到约 4 万字,理由是算力不足。北京日报采访的一位白领说:「之前让 DeepSeek 整理的一份会议纪要,今天把那个任务对话翻出来,想再找出来加工一下,结果发现不能在原有对话框里继续了。」
这条限制只管普通用户,不管调接口的企业。但它说明一件事:上下文在厂商那边是有成本的,过去几个月是他们替你付了。
早算的人,报价单上敢写按调用量结算;不算的人,只能签包干价,把风险留给自己。你们在用的 AI 功能,最近三个月的账单是涨是跌?留言说说,我一条条回。
如果你正在评估类似方案,把你的场景留言或私信给我们,免费出一份「流程图+架构图+报价明细」方案。
15730313844(同微信)|官网 www.byten.com.cn
—— 拜腾科技,帮企业把 AI 接进业务系统
AI 功能一个月大概多少调用费?
看三个数:日均提问量、每问调用次数、单次输入 token。日均 1,000 条、每问 5 次、单次 5,000 token 的系统,月输入约 550 百万 token,未治理约 550 元,做了缓存治理通常压到 200 元以内。没有这三个数,任何报价都是猜。
换个便宜的模型能直接降本吗?
能降一档,降不了量级。单价从 1 元降到 0.2 元省 80%;单轮输入从 12,000 压到 3,800 省 68%;命中率从 3% 回到 60%,再省 98%。模型单价是最容易换、也最容易失效的一档——调用量第二年涨上去,它就回来了。
怎么判断供应商做的 AI 会不会越用越贵?
三句:能导出分三列的 usage 报表吗;单轮输入 token 的中位数多少;缓存命中率连续七天多少。三句都答不上来,成本风险在自己身上。
成都做企业 AI 应用定制开发多少钱?
单场景 AI 功能 8 万到 25 万,Agent 项目 10 万到 30 万,周期 6 到 12 周,应包含上下文治理和成本看板(这块通常 1.5 到 3 人月)。成都本地可上门,全国远程交付。

